API-ul PlagiarismSearch: Întrebări și răspunsuri despre integrare
Un ghid practic pentru accesul API, verificări asincrone anti-plagiat, apeluri inverse, rapoarte, stocare (Storage) privată, filtre și probleme comune de integrare.
Capturile de ecran prezintă un flux de lucru API anterior. Verificați documentația v3 conectată și setările contului dvs. înainte de a implementa integrări de producție.
Ce poate face API-ul PlagiarismSearch?
API-ul RESTful PlagiarismSearch permite dezvoltatorilor să trimită text sau fișiere acceptate pentru analiza similarității, să recupereze rezultate și informații despre surse și să conecteze verificarea plagiatului la fluxul de lucru propriu al unei organizații. Spațiul de stocare privat Storage poate permite compararea cu documentele pe care clientul alege să le indexeze.
Funcțiile și permisiunile API depind de cont și de serviciile activate. Nu presupuneți că operațiunile de reseller, accesul la scriere în spațiul de stocare (Storage) sau detectarea textului generat de inteligența artificială sunt incluse în fiecare cont. Un indiciu de text generat de inteligența artificială este separat de o constatare de plagiat sau de similitudine.
Cum obțin acces API și acreditări?
Începeți cu prezentarea generală publică a API-ului anti-plagiat și cu documentația API. Dacă este necesar acces la o perioadă de probă sau prețuri, contactați services@plagiarismsearch.com pentru a confirma termenii actuali. Materialele mai vechi descriu o perioadă de probă de 30 de zile cu 100 de trimiteri, dar acele drepturi exacte nu au fost verificate pentru înregistrările actuale.
Pentru un cont existent, utilizați pagina confirmată Acreditări API din aplicație pentru a verifica utilizatorul și cheia API. Păstrați acreditările pe server. Nu inserați niciodată chei active în tichete de asistență, cod sursă public sau într-o aplicație disponibilă exclusiv în browser.
Cum funcționează fluxul de lucru pentru rapoarte asincrone?
- Trimiteți un text, un fișier sau o adresă URL publică permisă prin reports/create.
- Înregistrați ID-ul raportului returnat și verificați dacă solicitarea a fost acceptată. Soldul și permisiunile contului pot afecta procesarea.
- Serverul procesează conținutul trimis în mod asincron. Timpii de procesare variază în funcție de dimensiunea documentului, resursele disponibile și opțiunile de analiză selectate; nu vă bazați pe o garanție fixă de finalizare.
- Primiți o notificare de finalizare la adresa configurată
callback_urlsau utilizați fluxul de lucru documentat privind starea raportului, acolo unde este cazul. - Obțineți detalii și linkuri disponibile către rapoarte folosind reports/{id}.
Consultați referința cererilor de apel invers. Punctul final ar trebui să fie accesibil prin HTTPS, să valideze cererile primite conform contractului de integrare actual și să gestioneze în siguranță reîncercările sau notificările duplicate.
Cum arată o cerere de creare a unui raport?
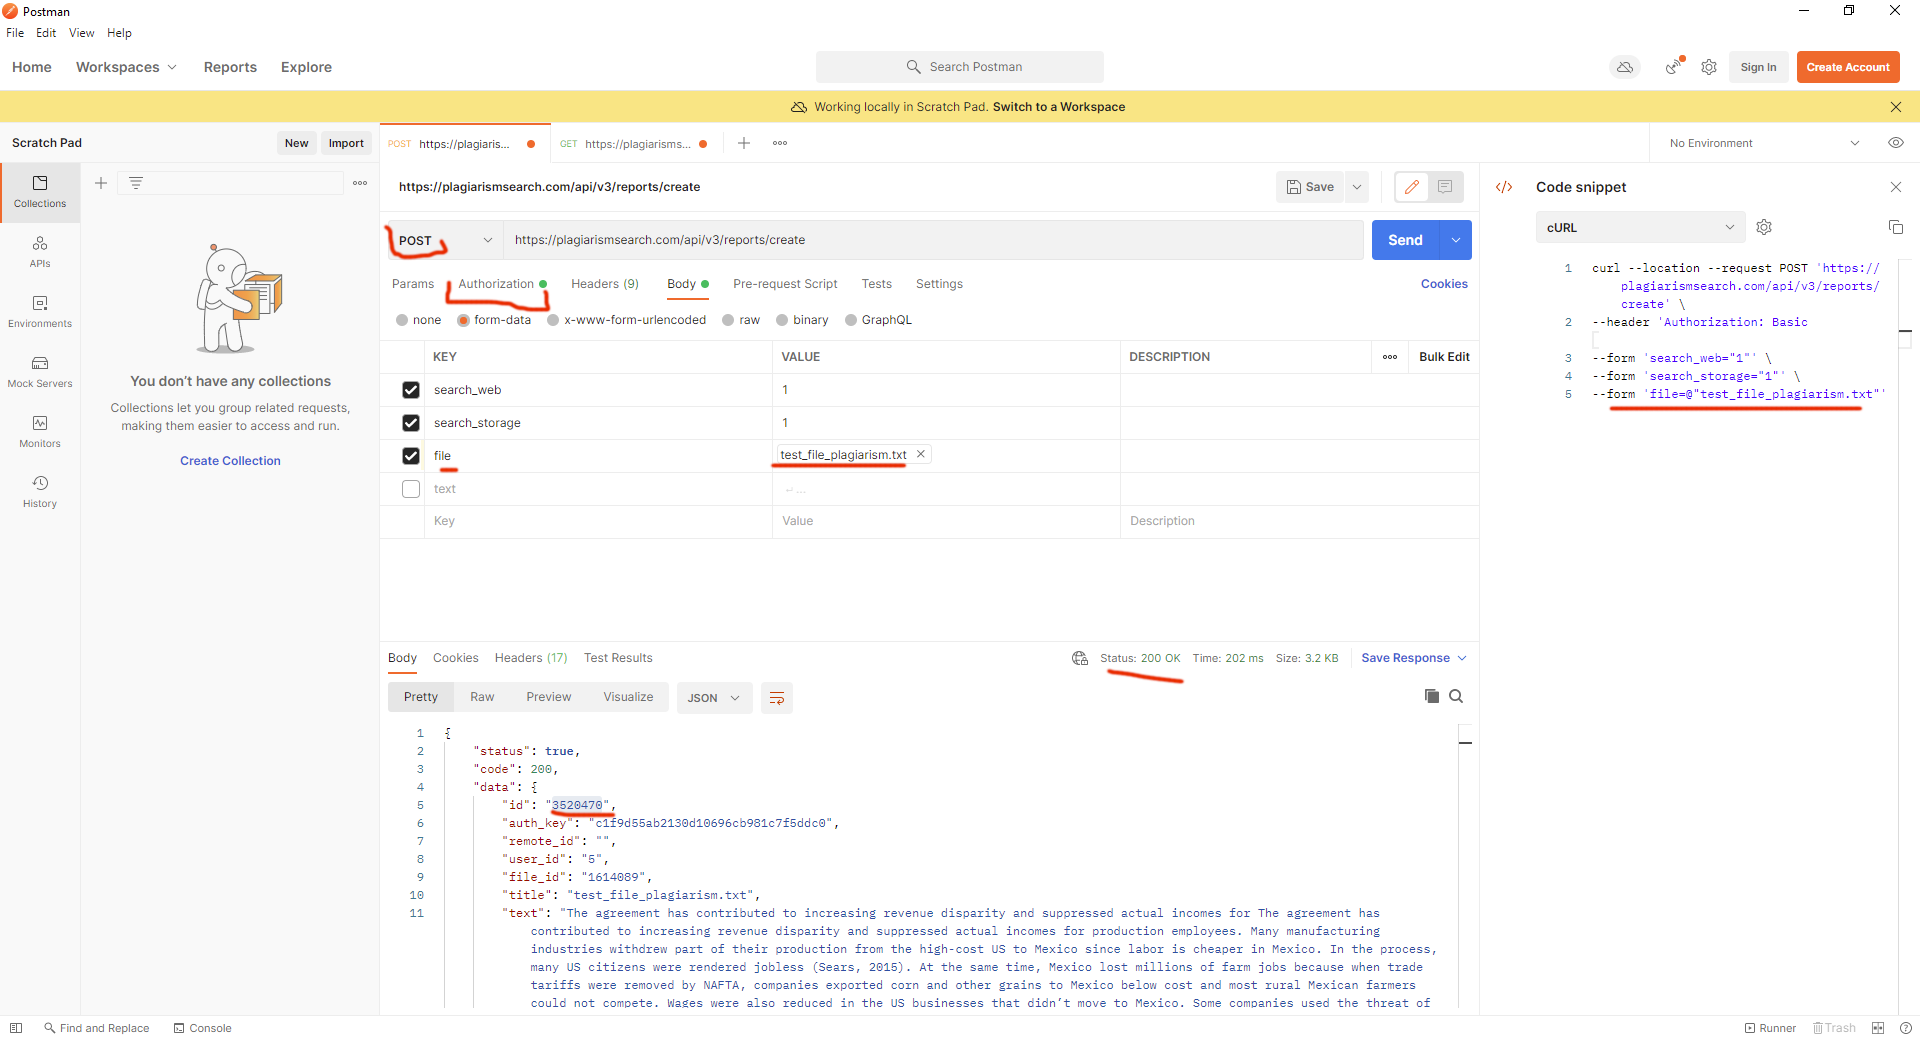
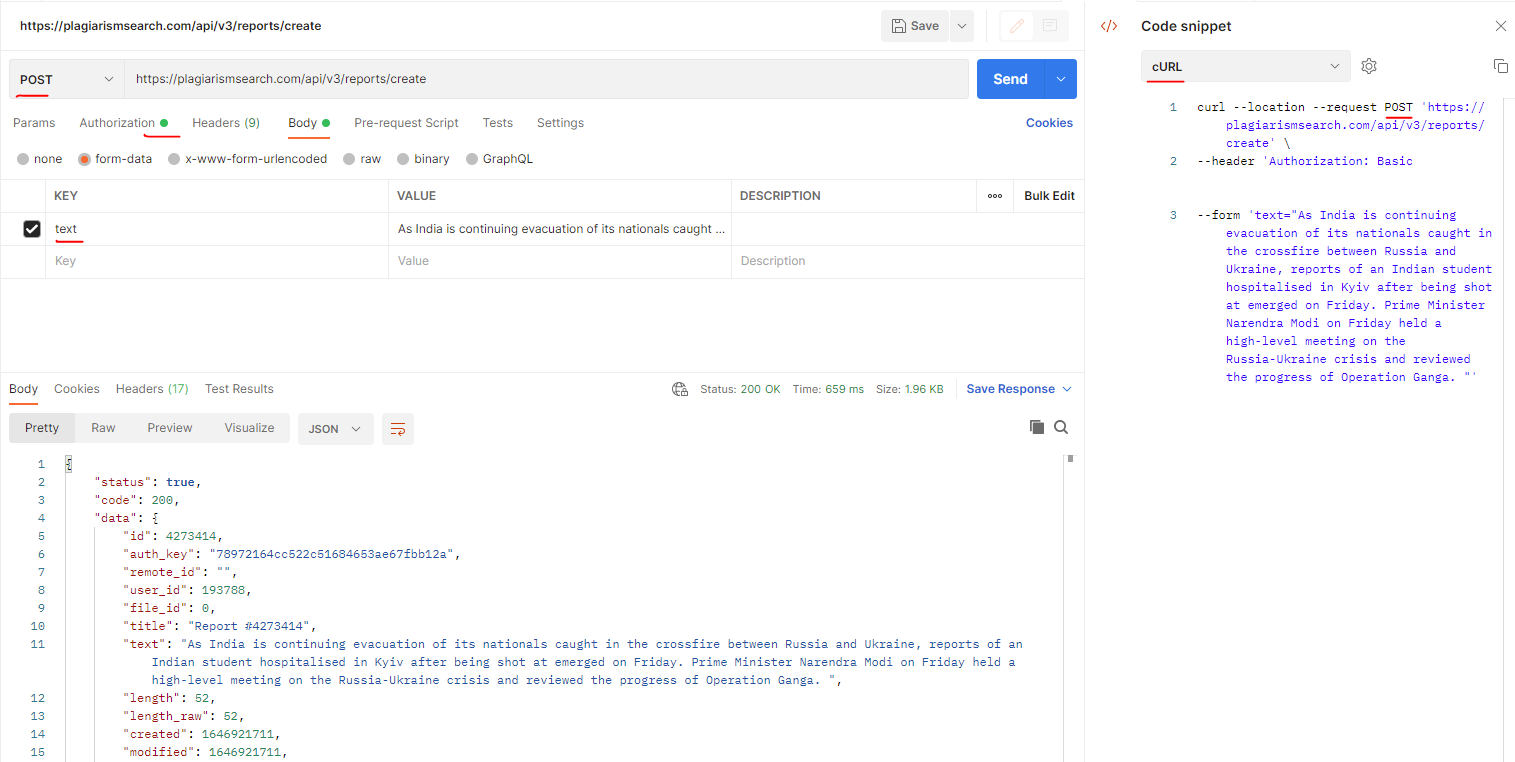
Metoda de creare documentată este POST, nu PUT. Exemplul de mai jos ilustrează forma unei cereri; utilizați utilizatorul și cheia API-ului server-side și confirmați parametrii exacți acceptați în documentație.
curl --request POST \
  'https://plagiarismsearch.com/api/v3/reports/create' \
  --user 'YOUR_API_USER:YOUR_API_KEY' \
  --form 'text=Example document text for a similarity check.' \
  --form 'search_web=1' \
  --form 'search_storage=0' \
  --form 'callback_url=https://your-domain.example/api/plagiarism-callback'
Folosește câmpul de formular file atunci când trimiți un fișier. Documentația API descrie, de asemenea, url, title, remote_id și filtre opționale. Evită să incluzi acreditările de autentificare în șirurile de interogare sau în capturile de ecran.
Cum trimit un fișier și verific un raport?
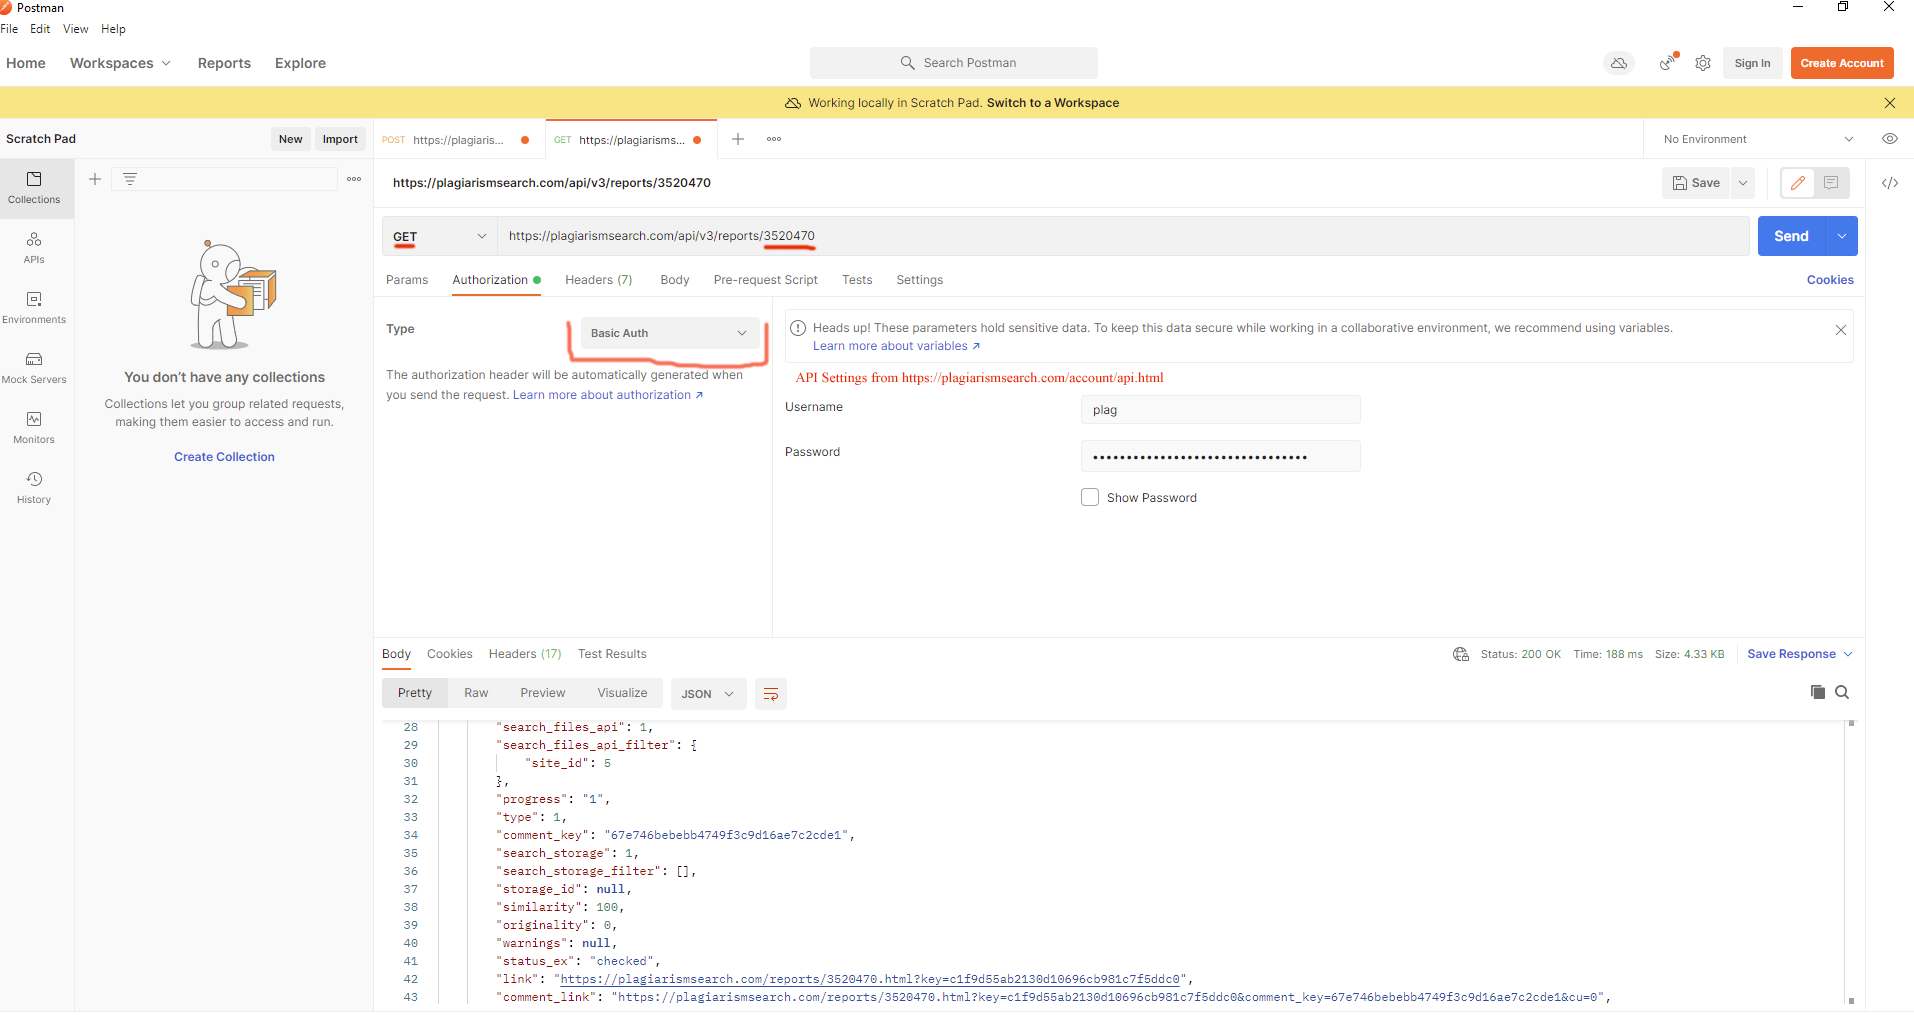
O trimitere tipică de fișiere utilizează câmpul documentat file; un raport completat poate fi recuperat prin GET /api/v3/reports/{id}. Aceste două capturi de ecran sunt păstrate din ghidul de integrare mai vechi și sunt ilustrative, mai degrabă decât un înlocuitor pentru referința API actuală.
Cum pot recupera surse și detalii din raport?
Punctul final de vizualizare a raportului v3 acceptă show_relations. Valorile documentate ajută la controlul cantității de informații returnate:
0— informații de bază despre raport (implicite).1— arbore structurat al raportului cu paragrafe, propoziții, surse și text evidențiat.-1— relații brute de raportare.-2— o listă de potriviri cu sursele.-3— Conținut raport HTML, acolo unde este acceptat.
Exemplu: GET https://plagiarismsearch.com/api/v3/reports/REPORT_ID?show_relations=-2. Inspectați schema de răspuns din referința curentă a punctului final, în loc să construiți adrese URL din chei de raport vechi, codificate direct.
Scorurile de similaritate și procentele surselor sunt dovezi pentru revizuire, nu determinări automate ale plagiatului. Câmpurile opționale pentru conținutul inteligenței artificiale, atunci când sunt disponibile, reprezintă o analiză diferită.
Pot descărca rezultate în format HTML și PDF?
Răspunsurile la raport pot include un link HTML accesibil din browser și intrări într-o matrice files pentru variantele PDF, în funcție de răspunsul contului și al API-ului. Se preferă adresele URL ale raportului returnate pentru raportul respectiv în loc să se concateneze manual ID-urile și cheile de acces.
Nu expuneți adresele URL ale rapoartelor cu chei de autorizare în pagini sau jurnale indexate public. Accesul la rapoarte și păstrarea acestora sunt supuse regulilor de cont curent, partajare și păstrare a datelor; vechea afirmație conform căreia fiecare raport rămâne disponibil pentru totdeauna nu ar trebui utilizată. Consultați ghidul de interpretare a rapoartelor de similaritate și informațiile despre gestionarea datelor.
Cum funcționează excluderile și filtrele de căutare?
Punctul final de creare documentează filtrele de referințe și citate, selecția Web și Storage și opțiunile URL. De exemplu, filter_references și filter_quotes sunt aliasuri documentate pentru excluderea conținutului din liste de referințe sau citate; search_web și search_storage aleg colecțiile sursă.
Documentația API distinge search_web_disable_urls de search_web_exclude_urls. Acesta din urmă poate lăsa vizibile dovezile corespondente, excluzând în același timp site-urile selectate din scorul calculat. Un scor mai mic după aplicarea excluderilor nu înseamnă că textul original s-a modificat sau a devenit mai original.
Folosește ghidul filtrelor de căutare pentru interpretare. Verifică setările pentru text nelatin și multilingv înainte de a activa filtrele care permit doar caractere latine.
Cum încarc și interoghez stocarea (Storage) privată?
Stocarea (Storage) privată este o colecție opțională controlată de client pentru compararea cu documente selectate indexate anterior. Este diferită de un istoric de raport. Ghidul vechi arată ruta de încărcare POST /api/v3/storage/create și face referire la câmpul de stare is_in_index; confirmați aceste operațiuni și permisiunile aferente în referința API curentă a contului.
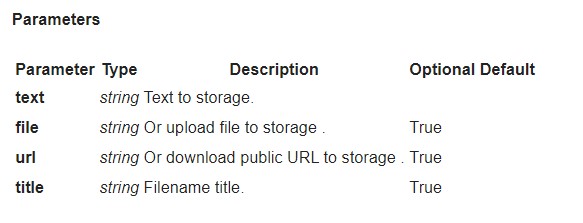
Încărcați doar documentele pe care sunteți autorizat să le procesați și să le indexați. Adăugarea unui document în Storage este diferită de verificarea similarității unui document nou; evitați salvarea automată a fiecărui text trimis, cu excepția cazului în care fluxul de lucru o impune în mod explicit.
API-ul acceptă fluxuri de lucru pentru reselleri și pentru mai mulți utilizatori?
Documentația veche descrie conturile de reseller care creează înregistrări ale clienților și alocă resurse de verificare prin rute specifice resellerului. Aceste capabilități sunt dependente de cont și nu ar trebui prezentate ca disponibile în mod implicit. Solicitați services@plagiarismsearch.com pentru drepturile actuale ale resellerului, accesul la endpoint-uri și un plan de implementare securizat.
Nu folosiți niciodată exemplele vechi de parole ca modele de producție. Generați în siguranță acreditări unice, evitați returnarea parolelor brute către jurnale sau clienți și confirmați dacă fluxurile de lucru pentru crearea și alocarea clienților utilizează în continuare interfața moștenită /api/v3/reseller-customers.
De ce primesc erori 400, erori de autentificare sau rezultate în așteptare?
400 Bad Request
Verificați mai întâi metoda HTTP: endpoint-ul documentat pentru crearea raportului utilizează POST. Validați numele câmpurilor, tipul de conținut, dimensiunea fișierului, câmpurile de text obligatorii și răspunsul la eroare reală; o eroare HTTP 400 poate avea mai multe cauze.
401 / authentication error
Confirmați că perechea utilizator/cheie API este activă și trimisă cu fiecare cerere utilizând schema de autentificare necesară punctului final. Consultați pagina cu acreditări API a contului. Nu plasați chei secrete în JavaScript public și nu le partajați în capturi de ecran.
Documentul este încă în așteptare
Este posibil ca un raport sau un document Storage trimis să nu fie încă gata. Verificați starea raportului documentat sau starea de indexare a Storage-ului în loc să presupuneți o fereastră de finalizare fixă de 0-6 minute. Gestionați erorile și reîncercările separat de rapoartele finalizate.
Unde ar trebui să meargă dezvoltatorii în continuare?
Pentru o nouă integrare, începeți cu documentația API, confirmați funcțiile contului activate, apoi testați un mic eșantion cu text real și surse deliberat distincte. Înregistrați doar metadatele tehnice care pot fi păstrate în siguranță, protejați acreditările API și comparați un răspuns returnat cu schema documentată înainte de a crea rapoarte automate.
Pentru întrebări legate de acces sau configurare, contactați services@plagiarismsearch.com sau utilizați Centrul de ajutor. Pagina publică API-ul Plagiat descrie produsul și opțiunile de contact.